AI와 OpenTelemetry 로 성능 개선 자동화하기
안녕하세요, AI 프로젝트 관리 도구 뤼이도에서 인프라와 백엔드를 만들고 있는 김주윤입니다.
뤼이도 1.0에서 2.0으로 전환하면서, 기존 기능을 유지하고 성능을 개선하는 작업을 AI와 함께 진행했습니다.
기능이 같다는 건 생각보다 까다로운 조건입니다.
화면에 같은 데이터가 나온다고 끝이 아닙니다. 권한도 같아야 하고, 목록의 순서도 유지되어야 하고, 저장한 뒤 실행되는 작업도 빠지면 안 됩니다. 빨라졌는데 기존에 하던 일을 안 하고 있다면 성능을 개선했다고 할 수 없습니다.
AI는 코드를 빠르게 읽고 수정했습니다. 그런데 코드를 바꾸는 속도와 실제 서비스를 개선하는 속도는 달랐습니다. 바꾼 코드가 운영에서 효과가 있었는지 확인하려면, 결국 제가 다시 로그를 보고 결과를 전달해야 했습니다.
그래서 AI에게 더 많은 코드를 맡기기 전에, 시스템을 직접 볼 수 있는 구조부터 만들기로 했습니다.
OpenTelemetry 도입은 그 시작이었습니다.
“이 API가 느리니 개선해줘”라고 요청하면 AI는 여러 방법을 제안합니다.
쿼리를 합치거나, 인덱스를 추가하거나, 캐시를 넣거나, 순서대로 실행하던 일을 병렬로 바꾸는 식입니다. 각각의 제안은 그럴듯합니다. 코드만 봐도 개선할 만한 곳은 계속 나옵니다.
그런데 지금 느린 이유가 그것인지는 별개의 문제였습니다.
SQL 실행에 시간이 걸리는 건지, DB 연결을 얻지 못해서 기다리는 건지, GitHub나 Google 같은 외부 서비스의 응답을 기다리는 건지부터 알아야 했습니다. GraphQL 실행에 들어가기 전부터 시간이 흐르고 있을 수도 있었습니다.
사람이 작업할 때는 경험으로 의심할 곳을 정하고, 필요한 로그를 추가하고, 다시 확인할 수 있습니다. AI에게 일을 맡겨도 이 과정은 필요했습니다. 다만 매번 제가 중간에서 관측 결과를 정리해서 전달한다면, 작업 속도는 결국 제가 확인하는 속도에 묶였습니다.
AI가 직접 확인할 수 있게 해야 했습니다.
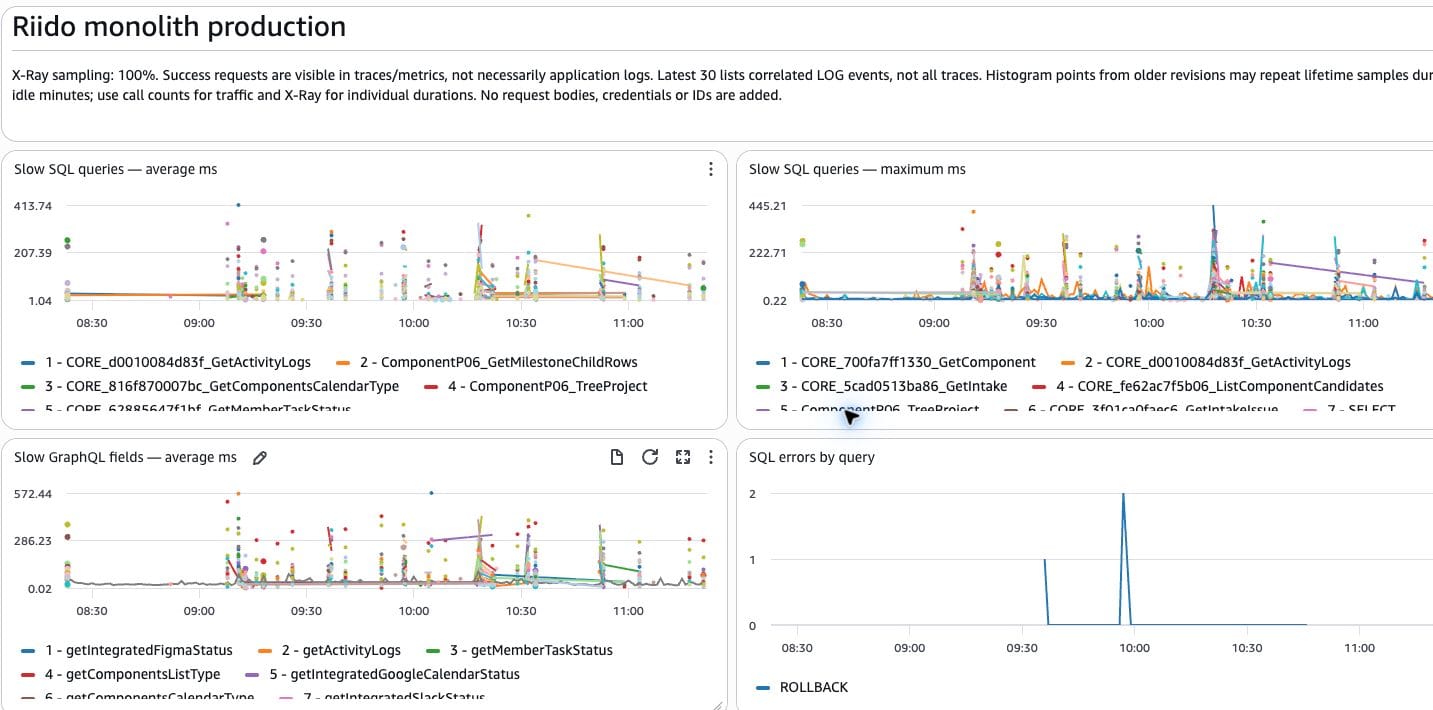
요청 안에서 GraphQL 실행, SQL, DB 연결 대기, 외부 호출을 구분해 시간을 남겼습니다. OpenTelemetry로 수집한 trace는 AWS X-Ray로, 지표와 로그는 CloudWatch로 연결했습니다.
SQL은 쿼리 이름별로, GraphQL은 필드별로 비교할 수 있게 했습니다. 느린 요청을 찾으면 그 요청의 trace를 따라가며 어떤 구간에 시간이 쓰였는지 확인했습니다. AI도 AWS CLI로 같은 정보를 직접 조회할 수 있게 했습니다.
이제 “느린 것 같다”는 설명 대신 실제 요청을 근거로 작업할 수 있었습니다.
로그를 보기 시작하자, 같은 느린 요청도 전혀 다르게 보였습니다.
어떤 목록 요청은 전체 응답에 약 3.25초가 걸렸습니다. 내부를 보면 결과를 구성하는 SQL에 약 2.35초, 조회 대상을 찾는 SQL에 약 384ms가 사용됐습니다.
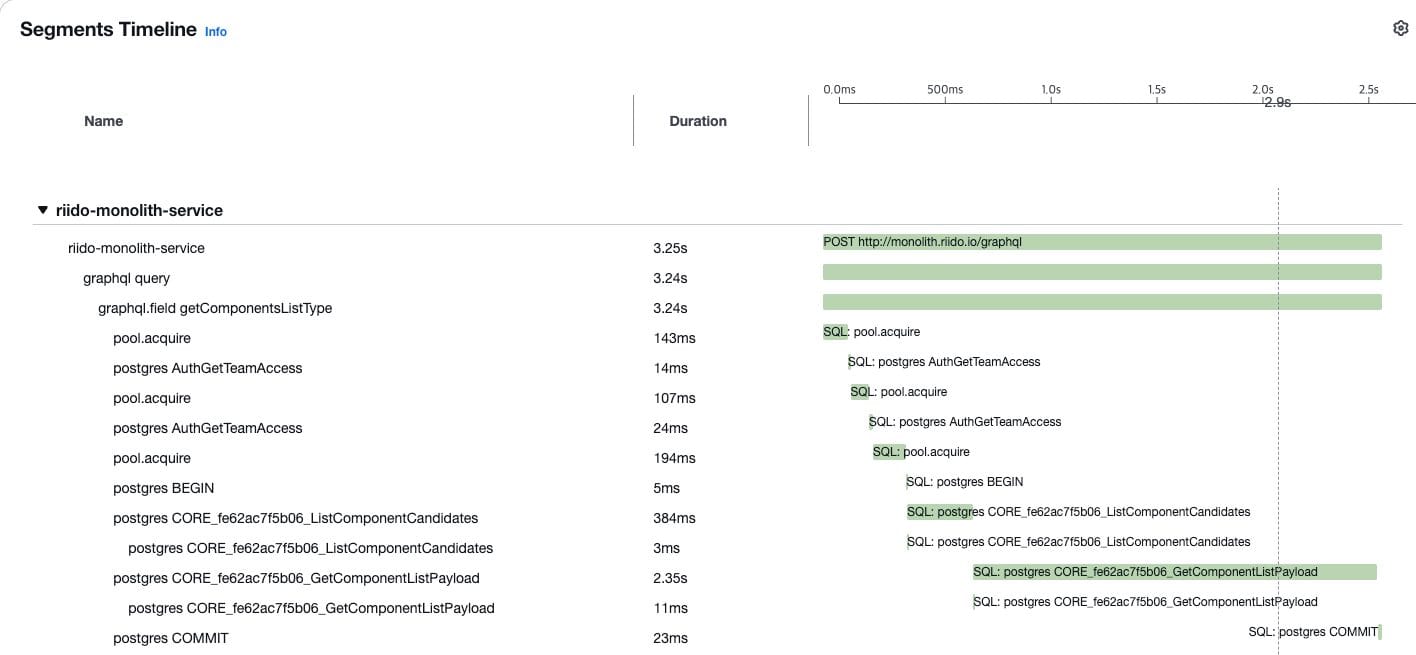
이 요청은 SQL부터 살펴볼 이유가 분명했습니다.
반면 다른 요청은 전체 시간이 약 10.78초였는데, GraphQL 실행은 약 306ms였습니다. 대부분의 시간이 GraphQL 실행 전에 흘렀습니다.
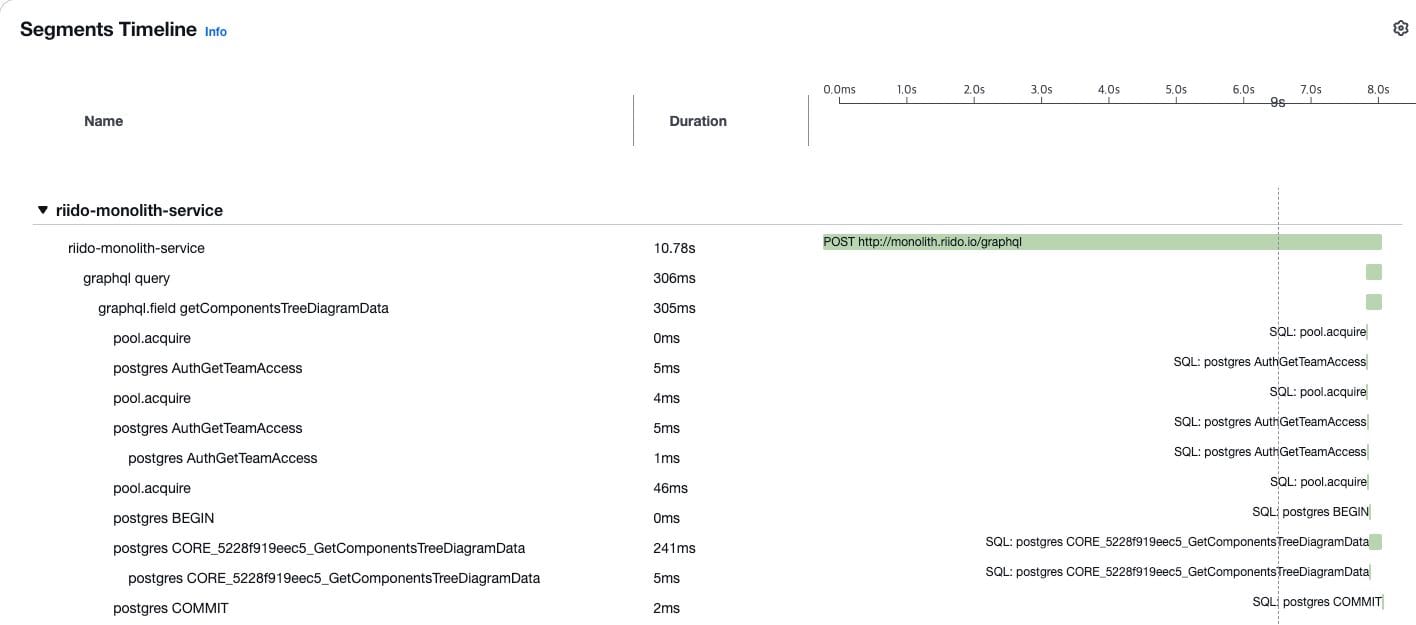
이걸 10초짜리 SQL 문제라고 생각했다면 엉뚱한 곳을 수정했을 겁니다. SQL을 아무리 줄여도, 실행 전에 기다리는 시간은 그대로 남기 때문입니다.
외부 서비스가 대부분의 시간을 차지하는 요청도 있었습니다. 약 5초짜리 요청에서 Figma 호출 두 개가 각각 약 4.56초와 398ms를 사용했습니다. 그동안 DB 트랜잭션도 연결을 잡고 있었습니다.
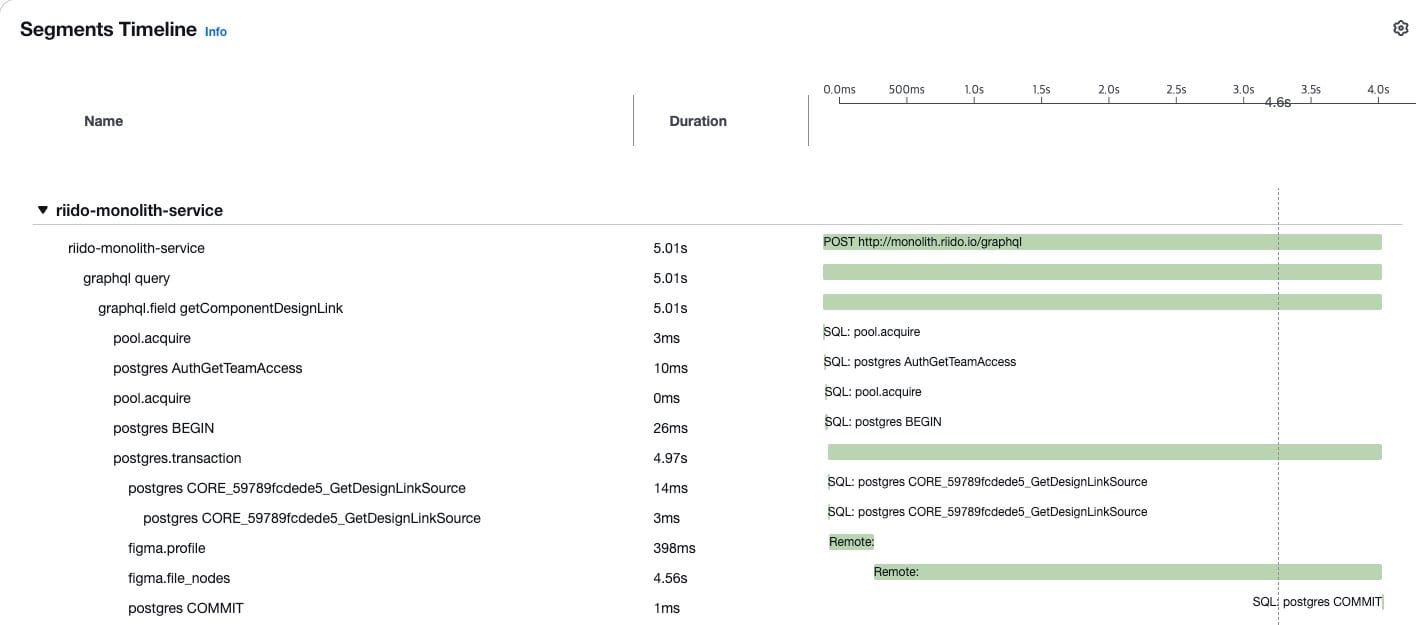
여기서는 질문이 달라집니다. Figma 응답을 기다리는 동안 DB 연결을 계속 가지고 있어야 하는지 확인해야 합니다. 그렇다고 바로 트랜잭션 밖으로 옮기면 되는 것도 아닙니다. 검증 순서와 실패했을 때의 동작이 달라질 수 있기 때문입니다.
관측이 생기자 AI에게 요청하는 일도 구체적으로 바뀌었습니다. “빠르게 만들어줘”보다 “이 구간이 오래 걸리는 이유를 확인하고, 기존 동작을 유지하면서 줄일 수 있는지 검증해줘”에 가까워졌습니다.
백로그 목록은 이렇게 개선한 사례 중 하나입니다.
기존 SQL은 백로그마다 댓글, 웹 링크, 파일 수를 반복해서 집계했습니다. 운영 데이터에서 열린 백로그 430개를 조회했을 때 SQL 실행시간이 약 8.56초까지 나왔습니다.
하나의 백로그에 필요한 집계가 목록 전체에서 반복되고 있었습니다. 데이터가 적을 때는 크게 드러나지 않았던 비용이었습니다.
조회 대상을 먼저 정하고, 관련 데이터를 관계별로 한 번씩 집계하도록 바꿨습니다. 필요한 조회 경로에는 보조 인덱스도 추가했습니다.
수정한 뒤에는 같은 데이터로 기존 SQL과 새 SQL을 비교했습니다. 항목 수만 맞는지 확인하지 않고, 전체 응답 값과 배열 순서까지 대조했습니다. 뤼이도 1.0에서 이어져야 하는 동작을 유지해야 했기 때문입니다.
운영 데이터에 대한 읽기 전용 비교에서 기존 SQL은 약 5.10~8.56초, 집계를 바꾼 후보 SQL은 약 0.11~0.28초로 측정됐습니다.
이후 인덱스와 애플리케이션 변경을 적용한 최종 검증에서는 HTTP 응답이 약 146~176ms, 계측된 SQL 구간은 약 38~51ms였습니다.
여기서 숫자를 한 줄로 줄이면 오히려 설명이 부정확해집니다. SQL 실행시간과 HTTP 전체 응답시간은 다릅니다. 최종 결과에는 SQL 재작성과 인덱스가 함께 기여했고, 실제로 인덱스만 먼저 적용한 단계에서도 기존 쿼리가 크게 빨라졌습니다.
그래서 최종 결과뿐 아니라 중간 단계도 남겼습니다. 그래야 무엇이 효과가 있었는지 다음 작업에서도 확인할 수 있습니다.
GitHub 저장소 목록은 SQL과 다른 문제였습니다.
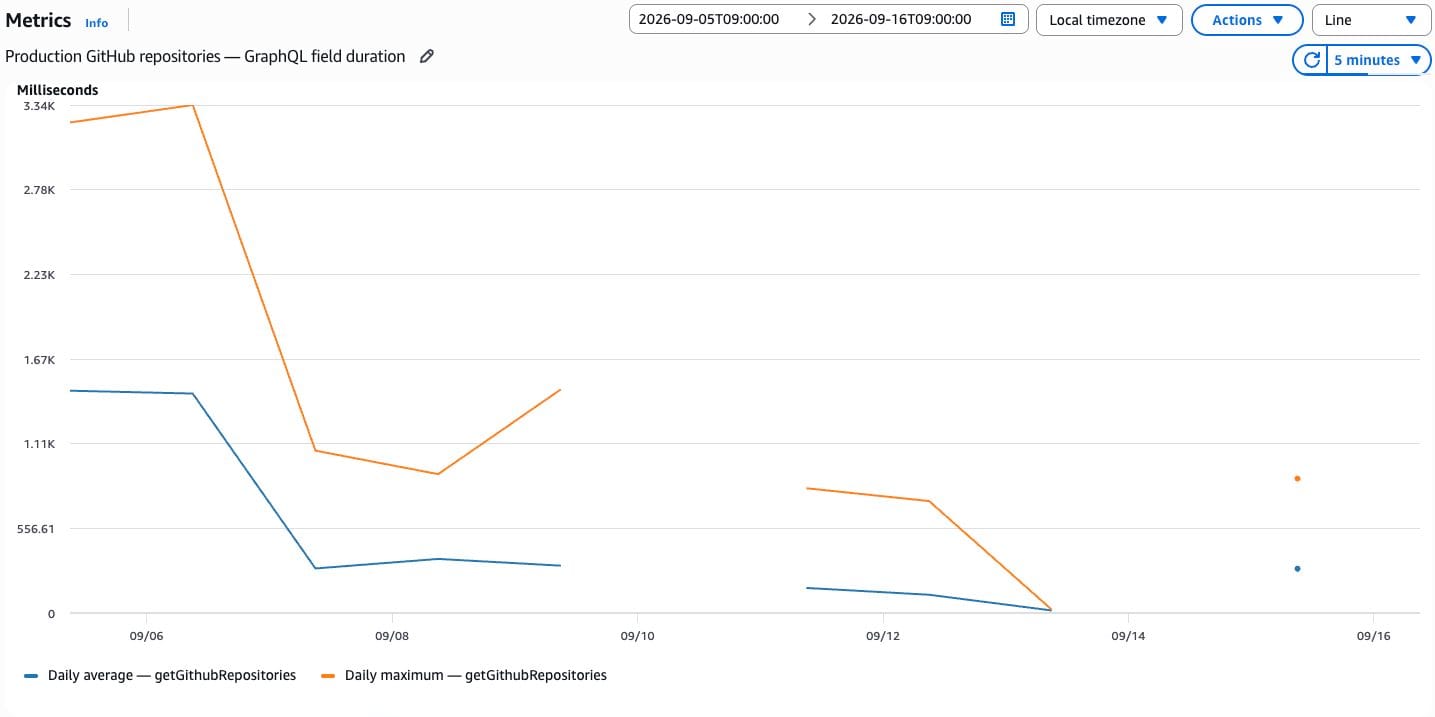
이 조회는 외부 API 응답을 기다리는 시간이 컸습니다. 내부 쿼리를 조금 줄이기보다, 목록을 요청할 때마다 외부 API에서 다시 받아야 하는지 검토하는 것이 먼저였습니다.
저장소 목록을 스냅샷으로 보관하고 백그라운드에서 갱신하도록 바꿨습니다. 요청마다 필요한 권한 검사는 그대로 수행하고, 준비된 목록이 있으면 그 결과를 읽게 했습니다.
운영 검증에서 기본 목록 조회는 변경 전 한 요청에서 1,142ms가 걸렸습니다. 스냅샷이 준비된 뒤 후속 요청은 53.0ms와 13.7ms였습니다. Trace에서도 외부 GitHub 호출 없이 스냅샷을 읽은 것을 확인했습니다.
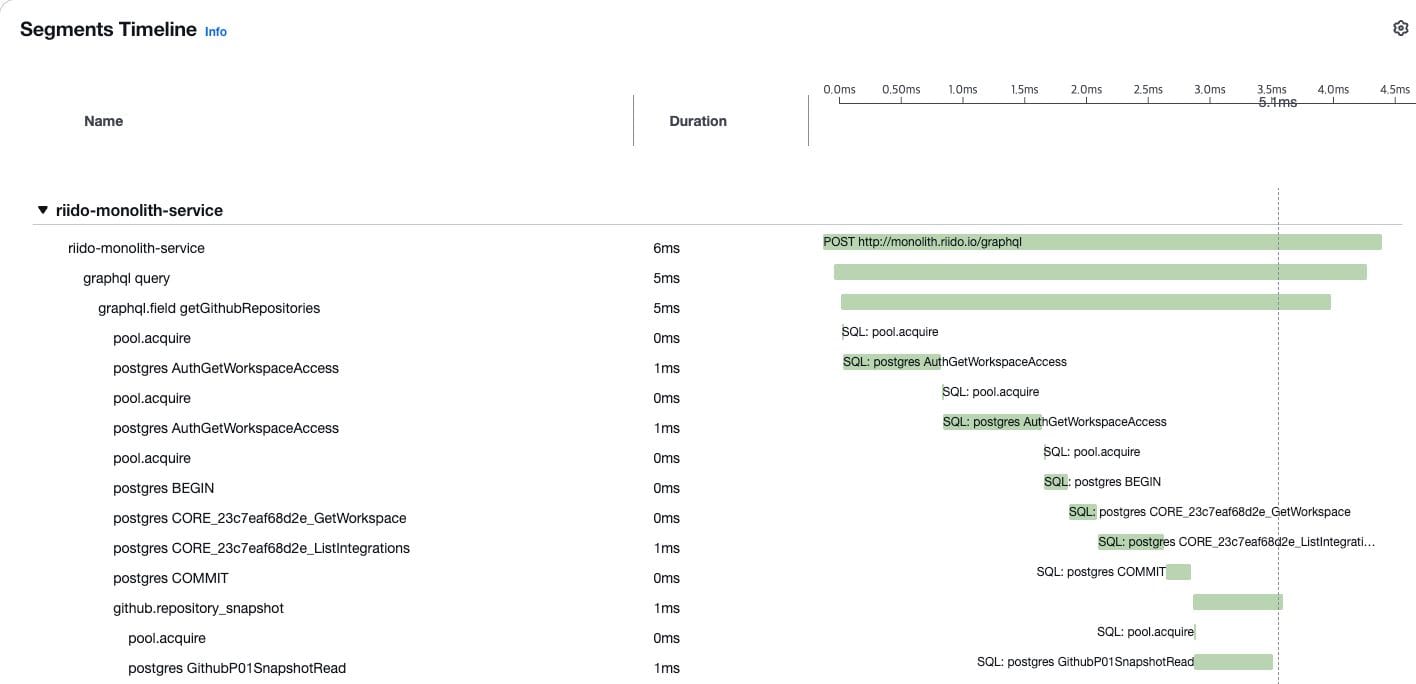
다만 최초 적재는 1,250ms였습니다. 처음부터 모든 요청이 빨라진 것은 아니었습니다. 준비된 결과가 있는 요청에서 외부 대기를 줄인 것입니다.
이런 변경은 AI가 구현하기 전에 사람이 정해야 할 것이 있습니다.
목록이 얼마 동안 이전 상태여도 괜찮은지, 권한은 언제 확인해야 하는지, 외부 API가 실패하면 어떻게 응답해야 하는지 결정해야 합니다. 저장소 목록에 적용한 방식을 모든 외부 연동에 똑같이 적용할 수도 없습니다.
AI가 구현할 수 있는 것과 제품에서 허용할 수 있는 것은 같지 않았습니다.
이 지점에서 사람과 AI의 역할을 나누는 기준도 조금씩 명확해졌습니다. 제가 모든 구현 방법을 정하기보다, 무엇을 유지해야 하고 무엇을 바꿔도 되는지 정하는 일이 중요했습니다.
관측을 붙였다고 모든 원인이 보이는 것은 아니었습니다.
AI도 관측되지 않은 구간의 내부에서 무슨 일이 일어났는지 정확하게 알 수는 없습니다. 다만 설명하지 못한 시간이 있다는 사실은 발견할 수 있습니다.
전체 요청이 10초인데 계측한 실행은 300ms라면, 나머지 시간을 더 살펴봐야 합니다.
실제로 약 60초 동안 이어진 HTTP 요청에 GraphQL 필드나 SQL 실행 구간이 없는 사례가 있었습니다. 이것만으로 느린 SQL이라고 할 수 없었습니다. 요청 본문을 읽는 과정인지, 다른 실행 전 단계인지 추가 관측이 필요했습니다.
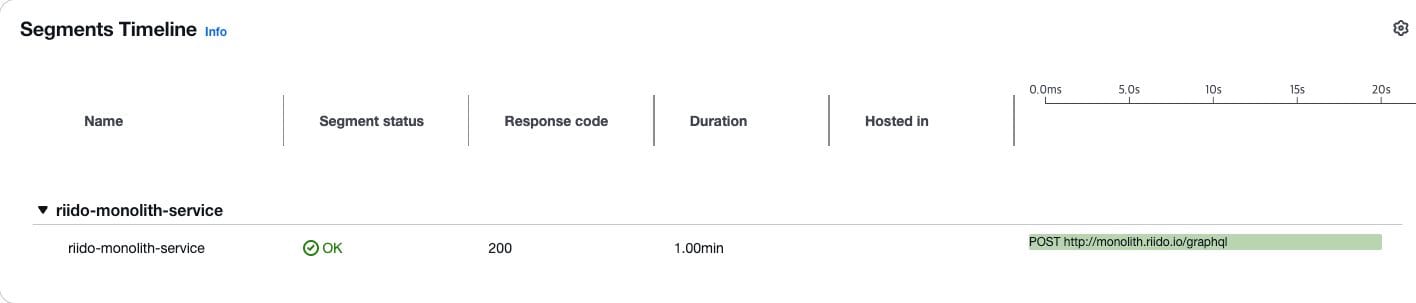
그래서 요청 본문을 읽는 데 걸린 시간과 읽기 실패 여부를 계측했습니다. 본문 내용을 로그에 남기지는 않았습니다. 원인을 모르는 상태에서 timeout 부터 바꾸지도 않았습니다. 기존 동작을 유지하면서 다음 요청에서 더 많은 것을 알 수 있게 했습니다.
이 작업은 성능 개선 완료가 아니었습니다. 아직 설명하지 못했던 구간을 다음에는 구분할 수 있게 된 것이었습니다.
사람이 해야 할 일에도 이런 부분이 남았습니다. AI가 내놓은 분석을 보는 것뿐 아니라, 분석에 필요한 정보가 애초에 수집되고 있는지 확인해야 했습니다.
AI에게 더 잘 생각해보라고 요청하기 전에, 무엇을 보고 생각하고 있는지 확인하는 일입니다.
이런 작업을 반복하면서 관심이 개별 최적화에서 작업의 루프로 옮겨갔습니다.
처음에는 코드 수정, 테스트, 배포가 끝나면 작업도 끝났다고 생각하기 쉽습니다. 그런데 성능 개선에서는 배포 이후가 빠지면 가설이 맞았는지 알 수 없습니다.
실제로 빨라졌는지 다시 측정해야 합니다. 응답은 같은지, 에러는 늘지 않았는지, 다른 요청의 DB 연결 대기가 커지지는 않았는지도 확인해야 합니다.
우리가 만들고 싶었던 흐름은 다음과 같았습니다.
관측 → 가설 → 변경 → 검증 → 배포 → 재관측
변경의 결과가 다시 다음 판단으로 돌아오는 폐쇄루프입니다.
폐쇄루프라고 해서 모든 단계를 AI가 혼자 수행해야 하는 것은 아닙니다. 사람이 중간에 판단하고 승인할 수도 있습니다. 중요한 건 작업을 수행했다는 사실로 끝내지 않고, 결과를 확인해서 다음 행동에 반영하는 것입니다.
실제 작업에서는 production과 staging의 로그를 보고 느린 요청을 찾았습니다. 해당 시각에 실행 중이던 버전과 관련 코드 변경을 확인하고 가설을 세웠습니다. 기존 응답과의 동등성을 검증한 뒤 staging에 배포해서 다시 측정했습니다. 확인된 변경을 production에 적용한 뒤에도 로그와 trace를 다시 봤습니다.
소스 버전과 배포 이미지, 실행 중인 태스크 정보도 함께 남겼습니다. 코드가 저장소에 들어간 것과 실제로 그 코드가 요청을 처리하고 있는 것은 다르기 때문입니다.
이 연결이 없으면 이전 버전의 로그를 보고 새 변경을 평가할 수도 있습니다. 열심히 측정하고 있어도 비교 대상이 틀리면 결과를 믿을 수 없습니다.
제가 생각하는 루프 엔지니어링은 이런 연결을 만드는 일입니다.
에이전트에게 도구를 붙이는 것에서 끝나지 않습니다. 무엇을 관측하게 할지, 어떤 기준으로 가설을 선택하게 할지, 어디까지 변경할 수 있게 할지, 무엇을 확인하면 완료라고 할지 정해야 합니다.
성능 작업이라면 먼저 측정 단위부터 맞아야 합니다. HTTP 전체시간인지, GraphQL 실행시간인지, SQL 시간인지 구분해야 합니다.
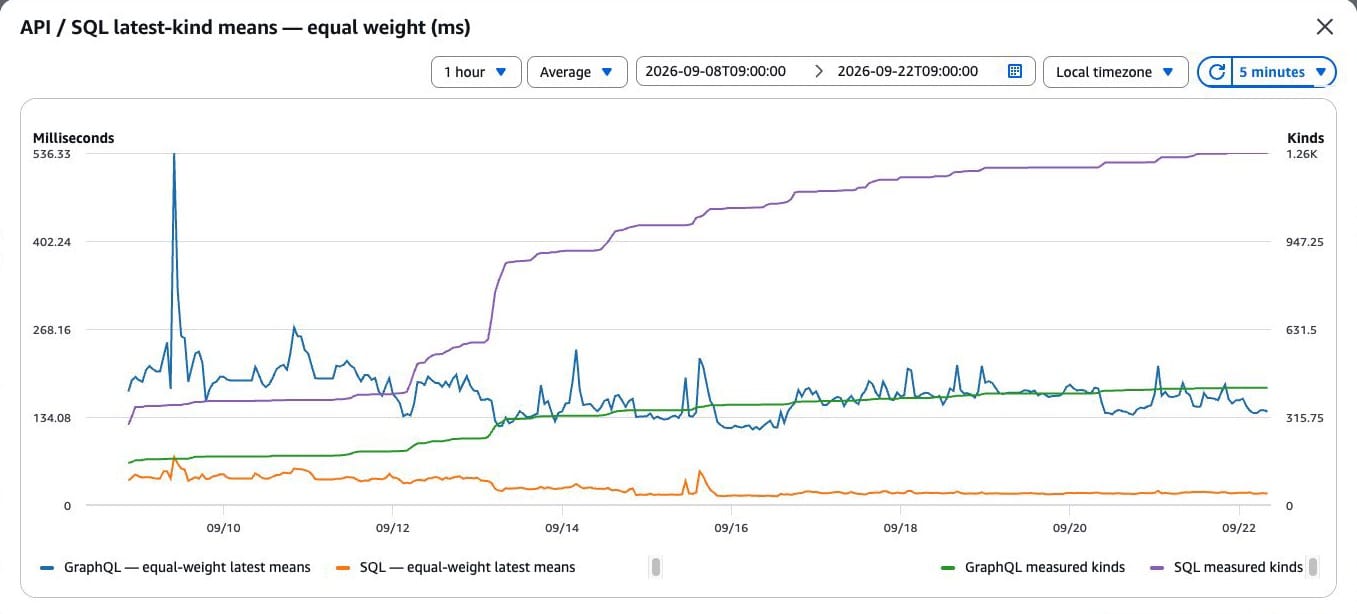
비교 기준도 필요합니다. 같은 입력으로 전후를 비교하는 것인지, 실제 운영 트래픽의 추세를 보는 것인지 알아야 합니다. 평균이 낮아졌더라도 빠른 요청의 비중이 늘어난 것일 수 있습니다.
변경 범위도 정해야 합니다. SQL만 바꿀 수 있는지, 공유 DB에 인덱스를 추가할 수 있는지, 스냅샷처럼 데이터 최신성을 바꾸는 방식까지 허용하는지 다릅니다.
완료 조건도 작업마다 달라야 합니다. 관측을 추가하는 작업이라면 실제 trace에 필요한 정보가 들어오는지 확인해야 합니다. 성능 개선이라면 변경 이후 효과를 확인해야 합니다. 둘을 같은 완료 상태로 처리하면 아직 해결되지 않은 문제가 사라진 것처럼 보입니다.
이 기준이 없으면 AI는 계속 개선할 일을 찾을 수 있습니다. 코드에는 손볼 곳이 많고, 더 나은 방법도 계속 제안할 수 있습니다. 하지만 많은 일을 했다고 필요한 일을 한 것은 아닙니다.
루프에는 다음 단계로 넘어가는 조건뿐 아니라 멈추는 조건도 있어야 했습니다.
근거가 부족하면 먼저 관측을 보강하고, 기존 응답이 달라지면 빨라져도 채택하지 않고, staging에서 문제가 생기면 production으로 넘어가지 않는 식입니다.
그 조건을 분명히 할수록 사람이 매번 같은 판단을 설명하는 일도 줄어듭니다.
실패한 가설을 남기는 것도 중요했습니다.
큰 목록에서는 효과가 있었지만 작은 목록에서는 차이가 없었던 SQL 변경이 있었습니다. 빨라졌지만 배열 순서가 달라져 적용하지 못한 인덱스 후보도 있었습니다. 로컬 계산은 크게 빨라졌지만 운영 전체 응답이 같은 비율로 개선됐다고 말할 수 없는 경우도 있었습니다.
이런 결과를 남기지 않으면 다음에 같은 작업을 할 때 같은 후보가 다시 나옵니다.
어떤 조건에서 효과가 있었는지, 무엇이 달라져서 채택하지 않았는지, 무엇을 아직 확인하지 못했는지 기록해야 했습니다. AI가 다음 작업에서도 읽을 수 있는 형태로 남기는 것이 중요했습니다.
관측과 검증 기록이 쌓이면 작업의 시작점이 달라집니다. 매번 처음부터 코드를 훑고 가능성을 나열하는 대신, 이전에 확인한 사실에서 이어갈 수 있습니다.
사람의 기억이나 대화 안에만 있던 내용을 시스템과 문서에서 다시 확인할 수 있게 되는 것입니다.
숫자를 정리할 때도 같은 기준이 필요했습니다.
처음에는 평균과 최대 지연을 간단히 전후로 보여주고 싶었습니다. 그런데 실제 자료를 다시 확인하니 평균에도 여러 종류가 있었습니다. 호출 횟수로 가중한 평균과 API 종류별 평균이 달랐고, SQL과 GraphQL, HTTP의 측정 범위도 달랐습니다.
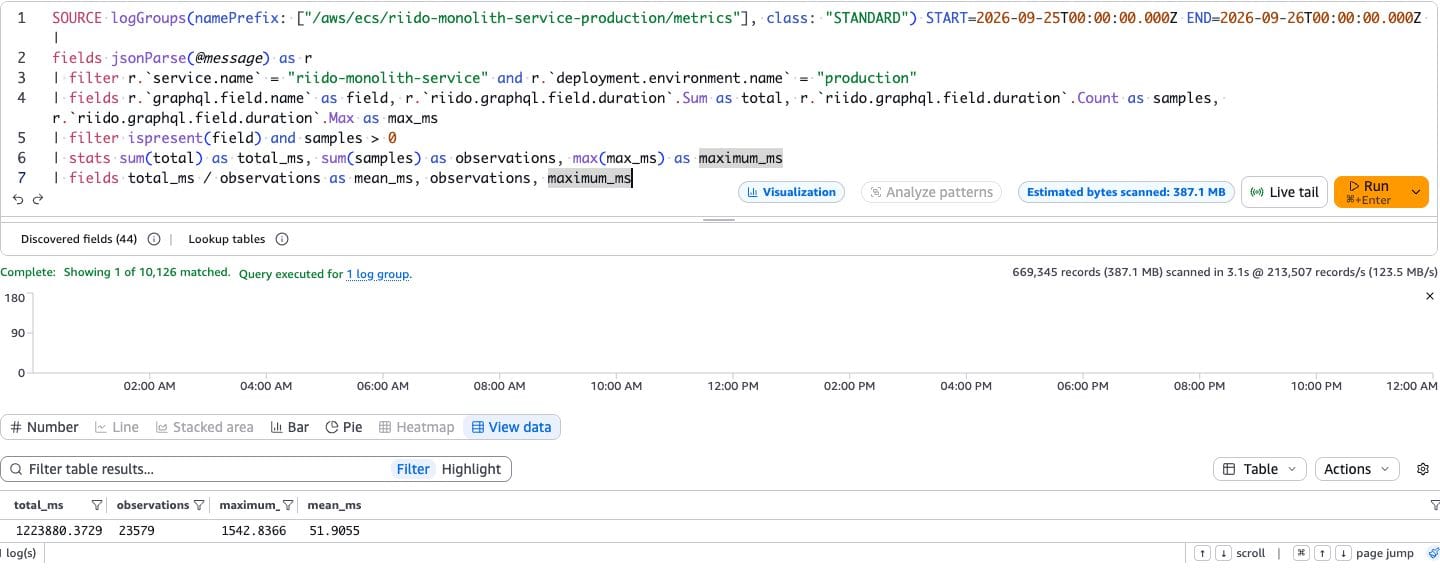
예를 들어 9월 25일 UTC 하루의 운영 로그에서는 GraphQL 필드 실행 23,579회에 대해 평균 약 51.9ms, 최대 약 1.54초를 확인했습니다
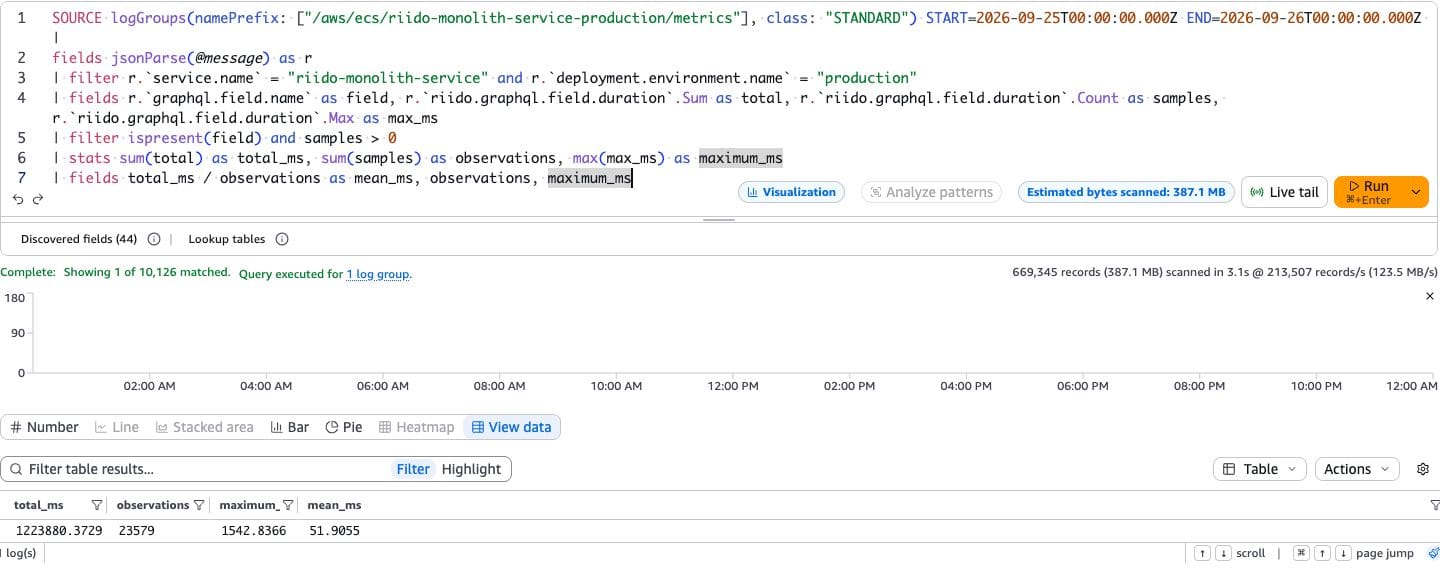
하지만 이후 날짜에는 더 긴 요청도 있었습니다. 이 하루의 결과를 모든 요청의 상한으로 말할 수는 없습니다. 서로 다른 날짜의 최대값만 가져와서 같은 기능이 그만큼 빨라졌다고 설명하는 것도 정확하지 않았습니다.
이 글에 나온 전후 수치도 뤼이도 2.0 전환 과정에서 개별 변경을 검증한 결과입니다. 뤼이도 1.0과 2.0 전체를 같은 부하로 비교한 벤치마크는 아닙니다.
AI가 작업하는 루프에서도 이런 구분이 필요합니다. 목표와 지표를 잘못 정하면 AI는 그 잘못된 기준을 열심히 맞출 수 있습니다.
우리가 줄이려는 것은 사용자가 기다리는 시간입니다. 그 과정에서 기존 기능과 결과를 유지해야 합니다. 평균이나 최대값은 그걸 확인하기 위한 근거로 사용해야 했습니다.
뤼이도 1.0에서 2.0으로 전환하면서 바뀐 것은 코드만이 아니었습니다. AI와 문제를 찾고 해결하는 방식도 바뀌었습니다.
사람이 로그를 읽고 다음 일을 하나씩 전달하던 구조에서, AI가 직접 관측하고 가설을 검증할 수 있는 범위를 넓혔습니다. 대신 사람은 목표와 변경 범위, 관측의 빈틈을 더 신경 쓰게 됐습니다.
AI가 시스템을 볼 수 있게 만든다는 것은 로그를 많이 쌓는다는 뜻만은 아니었습니다. 어떤 요청이 어떤 버전에서 실행됐고, 어디에서 시간이 걸렸으며, 변경 이후 무엇이 달라졌는지 연결해서 읽을 수 있어야 했습니다.
그 정보는 AI만을 위한 것도 아니었습니다. 사람이 문제를 이해하고 변경을 검토할 때도 같은 근거를 사용할 수 있었습니다.
코드를 수정하는 속도는 계속 빨라지고 있습니다. 이제는 그 수정이 맞았는지 확인하는 속도와 구조도 함께 바뀌어야 한다고 생각합니다.
다음에 AI에게 일을 맡길 때는 코드를 얼마나 잘 만드는지와 함께 이것도 확인해보면 좋겠습니다.
이 AI는 자신이 한 작업의 결과를 볼 수 있는가. 그리고 그 결과를 보고 다음 판단을 바꿀 수 있는가.
뤼이도에서 OpenTelemetry를 도입하고 검증 루프를 만든 이유입니다.
아래는 Agent Goal 에 대한 예시입니다
/goal

AI Agent가 코드만 수정하는 것이 아니라, 실행 중인 시스템을 직접 관측하고 변경 결과까지 검증할 수 있는 작업 구조를 도입해줘.

- OpenTelemetry를 도입해 HTTP, GraphQL, SQL, DB 대기, 외부 API 등 주요 실행 구간을 추적할 수 있게 한다.
- Agent가 trace, metric, log를 CLI/API 등으로 직접 조회할 수 있게 한다.
- 배포된 버전과 commit/image/task/trace를 연결해 어떤 코드가 실제 요청을 처리했는지 확인할 수 있게 한다.
- 성능 문제는 코드를 먼저 수정하지 말고 관측 → 가설 → 변경 → 검증 → 배포 → 재관측 순서로 진행한다.
- 관측되지 않는 시간이 있으면 추측해서 최적화하지 말고 필요한 instrumentation을 먼저 추가한다.
- 변경 전후에는 동일한 측정 단위와 조건으로 비교한다.
- 기존 응답, 정렬, 권한, side effect, transaction 등 기존 동작의 동등성을 검증한다.
- staging에서 효과와 regression을 확인한 뒤 production으로 진행한다.
- production 배포 후 실제 telemetry에서 개선 효과를 다시 확인한다.
- 관측 추가와 문제 해결을 서로 다른 완료 상태로 구분한다.
- 효과가 없거나 채택하지 않은 가설과 이유도 기록해 다음 작업에서 재사용할 수 있게 한다.
- 근거 부족, 동작 변경, regression, 제품 정책 결정이 필요한 경우에는 자동으로 다음 단계로 진행하지 않는다.

최종적으로 Agent가 자신의 변경 결과를 직접 보고, 그 결과를 근거로 다음 행동을 결정할 수 있는 closed-loop engineering 환경을 만들어줘.
읽어주셔서 감사합니다.